一、RTGS为什么也会让支付排队
上午10点,A银行在中央银行结算账户里的可用资金只有3,000万元,这时它要向B银行付一笔1亿元的款项。指令格式正确,收款账户信息无误,系统运行也正常。这笔钱付不出去,原因只有一个:付款行账户里的钱不够。
实时全额结算(Real-Time Gross Settlement, RTGS)常被理解成“提交即完成”。更准确的说法是,RTGS能够对符合规则且资金充足的支付指令逐笔、实时地完成结算;资金条件没有满足,指令就得等。我们在《为什么支付系统不把每一笔钱都马上结掉?》里比较过RTGS和延迟净额结算(Deferred Net Settlement, DNS)的取舍:RTGS逐笔结算,结算风险更低,代价是要占用更多流动性。本文接着往下看,当付款行的钱暂时不够时,RTGS怎样处理这些指令,又怎样让有限的资金结掉更多支付。
一笔支付进入RTGS后,大致经过下面几个环节:
| 环节 | 系统做什么 | 这时钱动了吗 |
|---|---|---|
| 提交指令 | 付款行把支付指令发送给系统 | 没有 |
| 指令校验 | 检查格式、参与者身份、账户状态等 | 没有 |
| 资金检查 | 检查付款行可用余额是否足够 | 没有 |
| 立即结算或进入队列 | 余额够则记账;不够则放入队列 | 立即结算时,资金完成划转 |
| 再次尝试 | 有新资金流入或优化程序运行时,重新处理排队指令 | 结算成功时才划转 |
| 最终结算 | 付款行账户记减、收款行账户记增,结算具有最终性 | 完成 |
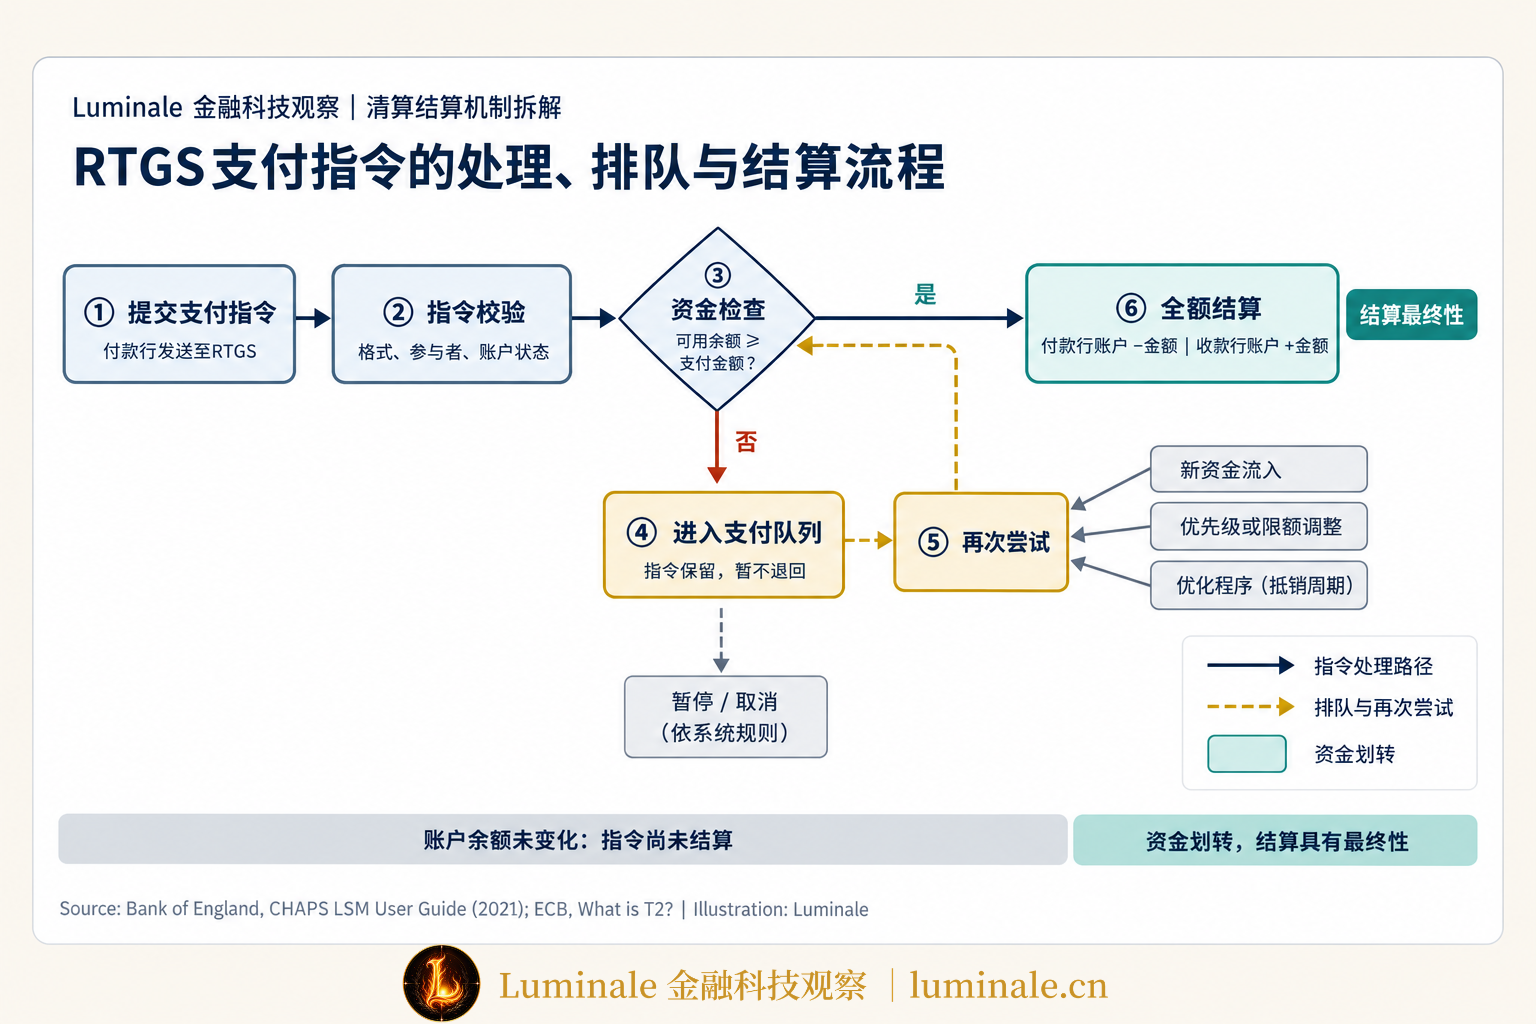
余额不足时,许多RTGS系统会先把指令放进队列(Queue),暂不退回。排队的指令可以等付款行后续收到的资金,也可以等系统的优化程序把它和其他支付配成一组结算。如果系统一律拒绝资金不足的指令,付款行只能反复重发,系统也就失去了在多笔支付之间统筹安排的机会。
入队和结算是两回事。指令进了队列,付款行账户没有扣款,收款行也没有收到钱,这笔支付尚未取得结算最终性。排队期间付款行能不能撤回指令、从哪个时点起不可撤销,取决于各系统的规则。以英国的CHAPS为例,直接参与者可以在指令排队期间调整它的优先级,也可以暂停或取消排队中的指令[1]。
所以,RTGS的实时性是有条件的,资金和其他规则条件同时满足,支付才能立即结算。排队是系统为暂时不能结算的指令准备的运行安排。
二、排进队列以后,谁先结算
队列怎么排,决定了有限的余额先用在哪几笔支付上。还是A银行为例,可用结算资金3,000万元,队列里有三笔待付款:
| 支付指令 | 金额 | 提交时间 |
|---|---|---|
| 第一笔 | 1亿元 | 10:00 |
| 第二笔 | 2,000万元 | 10:01 |
| 第三笔 | 1,000万元 | 10:02 |
如果系统严格按先进先出(First In, First Out, FIFO)处理,并且不允许越过队首,第一笔1亿元因资金不足卡在最前面,后两笔合计3,000万元的支付只能跟着等,尽管A银行的余额正好够付这两笔。这种现象叫队首阻塞(Head-of-Line Blocking)。
如果规则允许跳过暂时付不出的队首指令,结果就不一样了:
| 队列规则 | 当下能结算的支付 | 结算后A银行余额 | 仍在等待 |
|---|---|---|---|
| 严格先进先出,不越过队首 | 无 | 3,000万元 | 三笔全部 |
| 允许跳过暂时付不出的指令 | 第二笔、第三笔 | 0元 | 第一笔 |
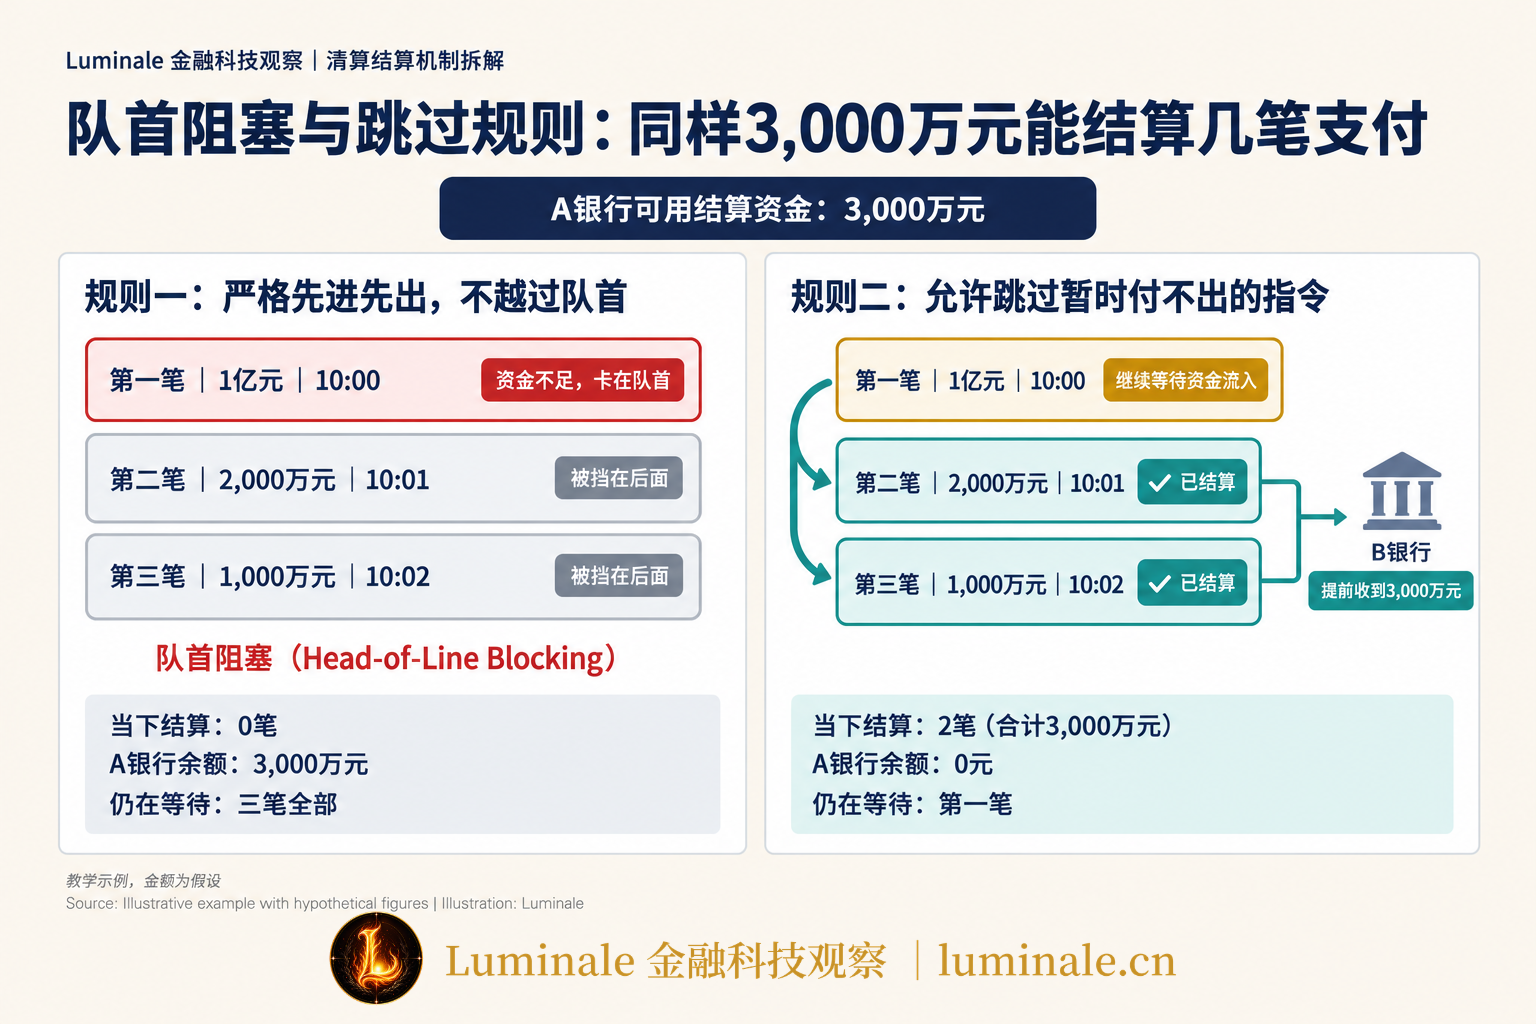
同样是3,000万元,一种规则下一笔都结不了,另一种规则下结掉两笔,收款方B银行也早一步拿到3,000万元,可以用这笔钱去付它自己的款项。
现实中的RTGS系统常见的队列安排有三类。
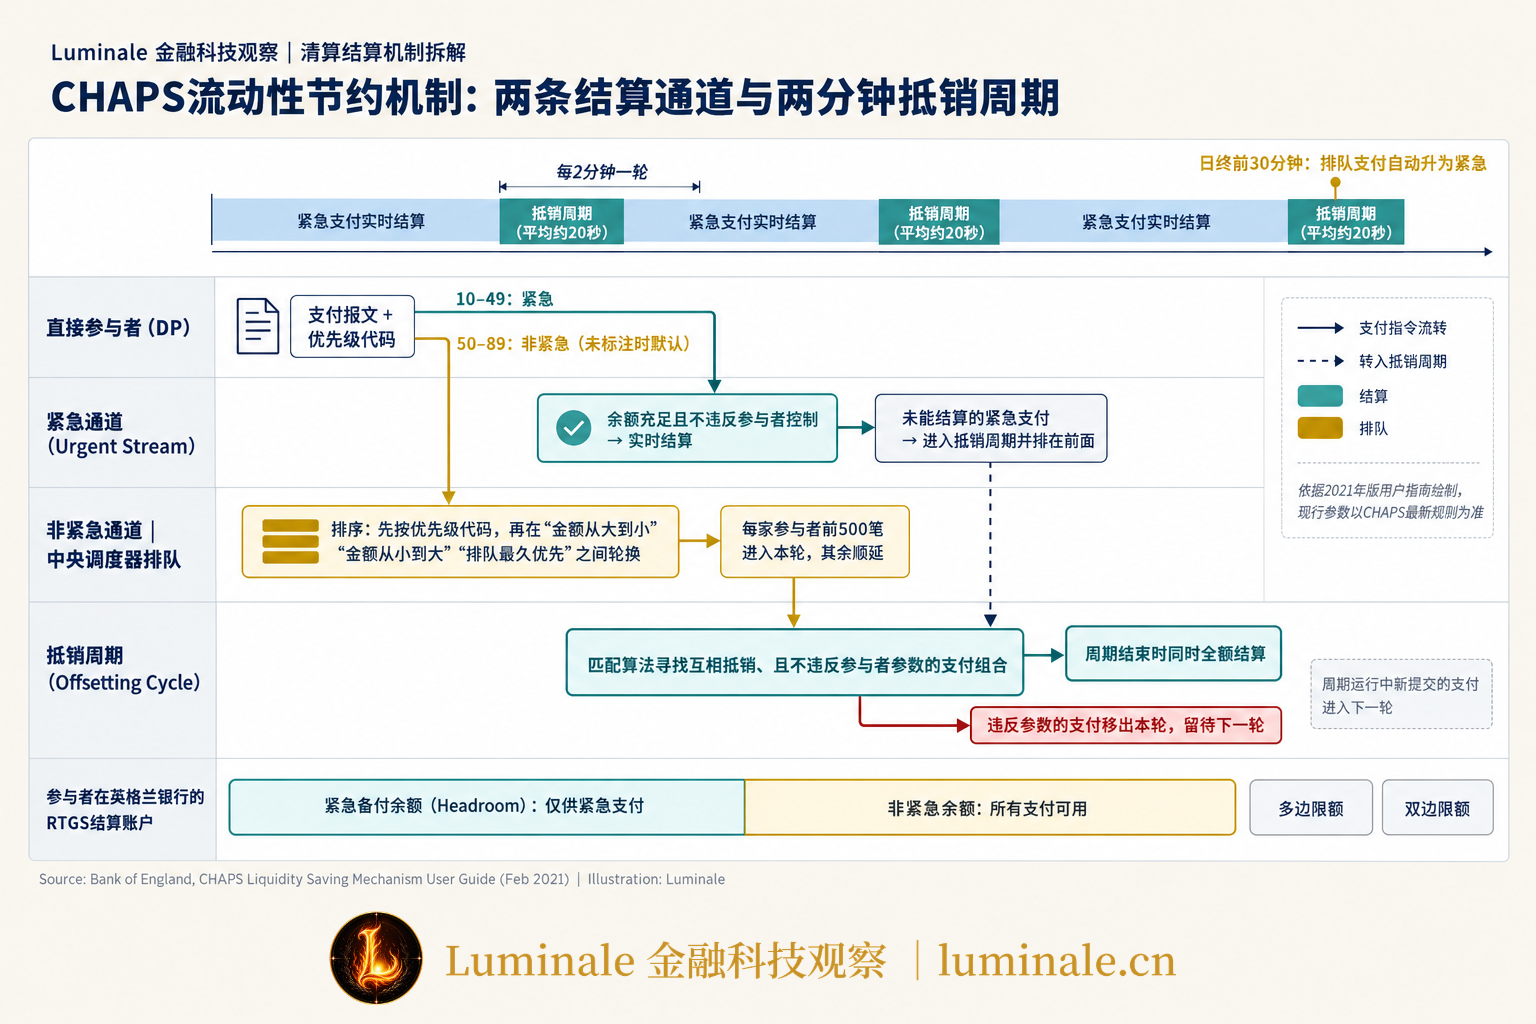
优先级调度(Priority Scheduling)。 参与者给支付业务标注紧急程度,系统据此决定处理顺序。CHAPS直接参与者通过支付报文里的优先级代码区分紧急和非紧急支付:代码10至49为紧急,进入紧急通道;代码50至89为非紧急,进入非紧急通道;没有标注的默认按非紧急处理[1]。紧急支付在余额允许时立即结算,非紧急支付先排队,等待与其他支付抵销。
队列重排与重复检查。 有新资金流入、限额调整或优先级变化时,系统会重新扫描队列,尝试结算此前没结掉的指令。仍以CHAPS为例,每一轮抵销计算前,排队支付先按优先级代码排序,再在“金额从大到小”“金额从小到大”“排队时间最长优先”几种方式之间轮换,避免某些支付一直排不上;每家参与者排在前面的500笔进入本轮计算,其余顺延到下一轮[1]。
参与者自己的流动性控制。 银行可以把一部分余额留给紧急支付,可以对单个对手方或全体对手方的净付出设限额,也可以规定支付排队超过一定时间后自动升为紧急。欧元体系的T2同样向参与者提供支付优先级、定时交易、流动性预留、限额、流动性池和优化程序等功能[3]。这些工具背后是银行日间流动性管理的一整套制度安排。
三、两家银行都在等对方的钱,能不能同时付
再看一个特殊情况:
| 项目 | A银行 | B银行 |
|---|---|---|
| 初始可用结算资金 | 10亿元 | 0亿元 |
| 待付款项 | 向B支付100亿元 | 向A支付90亿元 |
如果逐笔处理,两笔支付都会卡住。A银行要付100亿元,账上只有10亿元;B银行要付90亿元,账上是0。A在等B的90亿元到账后再付,B也在等A的100亿元,谁都动不了。
换个角度看这两笔支付:假如两笔同时结算,A银行付出100亿元、收到90亿元,净付出10亿元,恰好等于它手里的余额;B银行收到100亿元、付出90亿元,净收入10亿元。只要系统能识别出这两笔方向相反的支付,并安排它们在同一时点一起结算,两笔就都能完成。这就是双边抵销(Bilateral Offsetting)的思路。
| 项目 | A银行 | B银行 |
|---|---|---|
| 结算前余额 | 10亿元 | 0亿元 |
| 付出 | 100亿元 | 90亿元 |
| 收到 | 90亿元 | 100亿元 |
| 净头寸 | −10亿元 | +10亿元 |
| 结算后余额 | 0亿元 | 10亿元 |
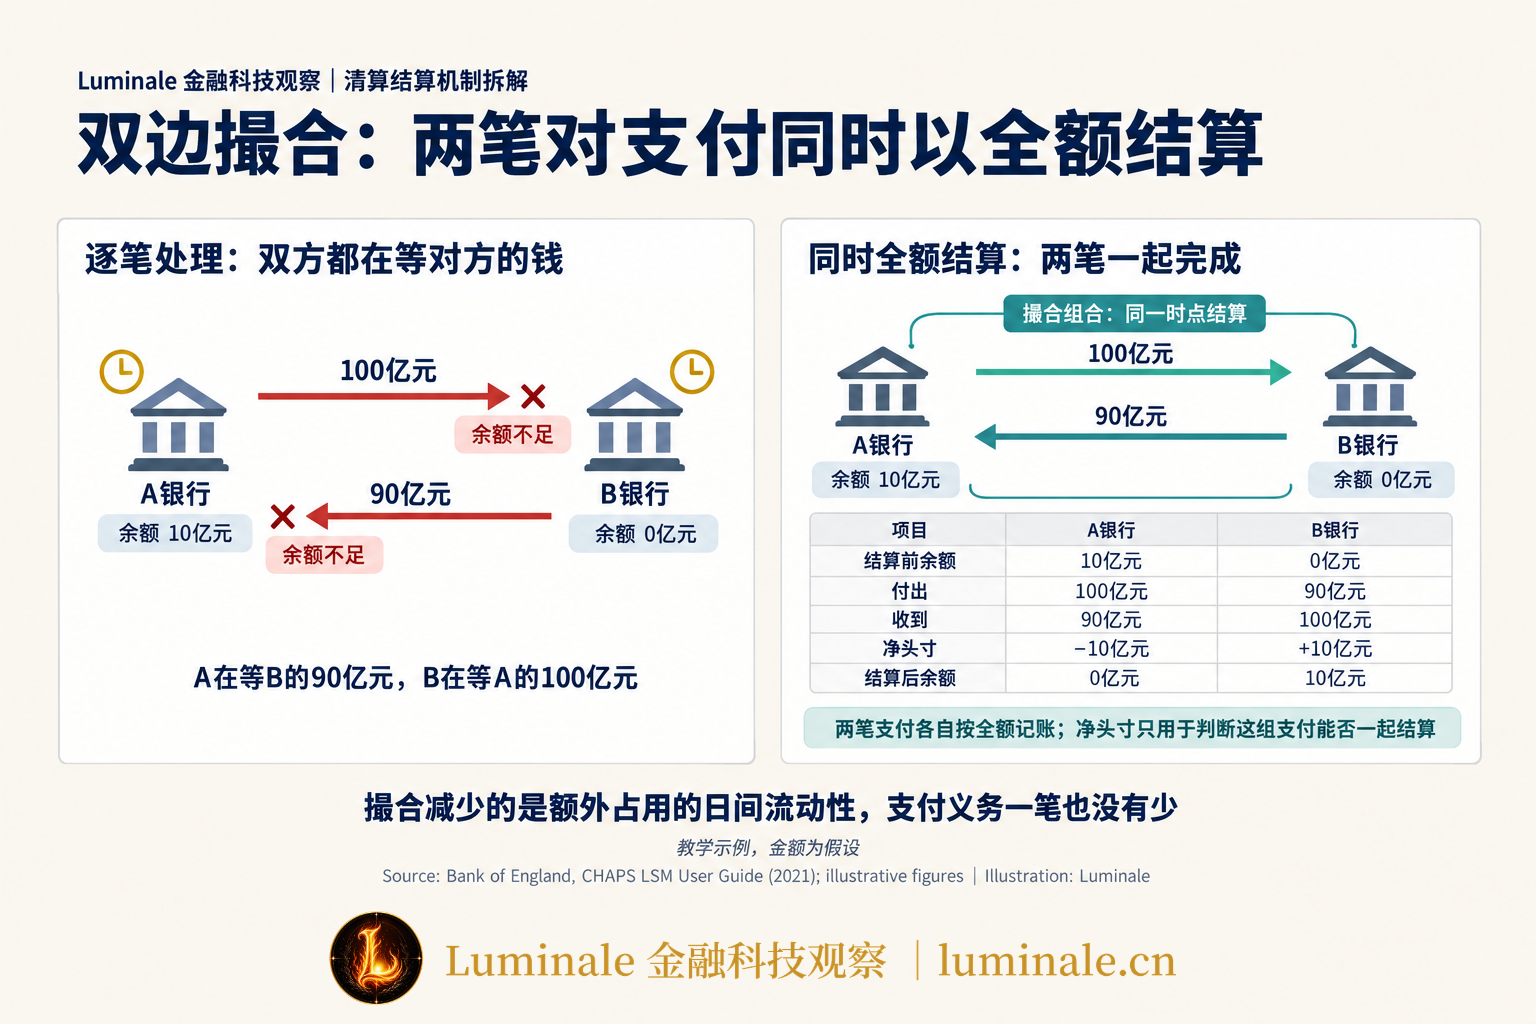
这种安排很容易被当成净额结算。DNS通常先在一段时间内累积支付,算出各参与者的净头寸,形成净额结算义务,再在约定时点结算净额。上面的安排在RTGS里运行,算法看净头寸,只为回答一个问题:这一组支付放在一起,各家的余额够不够。如果够,每一笔原始支付就以全额同时记账。英格兰银行在LSM用户指南中把这种方式称为同时全额结算(Gross Simultaneous Settlement),并说明它在法律上不同于净额结算,所需的流动性则与净额轧差后相同[1]。
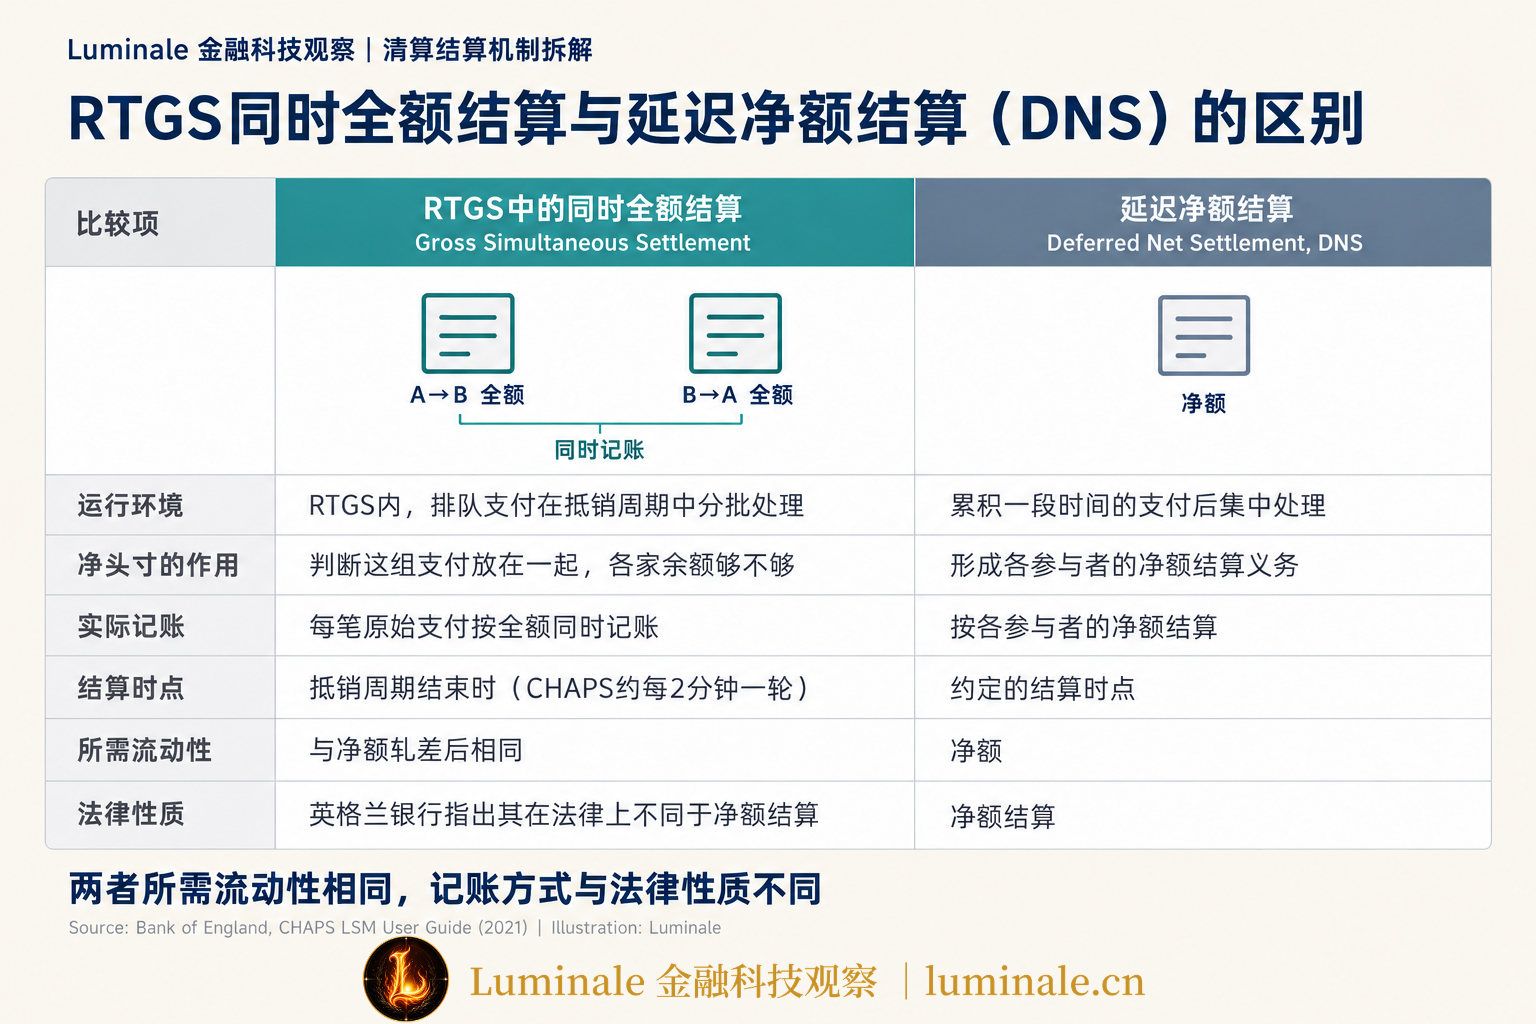
两者的差别落在结算最终性(Settlement Finality)上。同时全额结算下,被选入组合的每一笔支付都完成了自己的全额结算;没被选中的支付继续排队,不受影响。每笔支付在什么时点、以什么形式取得最终性,以系统规则为准。我们在《“支付成功”之后还能被撤销吗?》中讨论过最终性要解决的风险,感兴趣的读者可以对照阅读。
本文所说的支付匹配或撮合抵销,指系统在排队支付中寻找可以一起结算的组合,和证券交易里买卖订单的撮合成交含义不同。撮合减少的,是完成这些支付需要额外占用的日间流动性(Intraday Liquidity);银行要履行的支付义务,一笔也没有少。
四、三家银行转成一个圈:多边抵销怎样打破循环等待
把参与者扩大到三家:
| 支付方向 | 待结算金额 |
|---|---|
| A → B | 100亿元 |
| B → C | 90亿元 |
| C → A | 80亿元 |
初始可用结算资金:A银行20亿元,B银行0亿元,C银行0亿元。
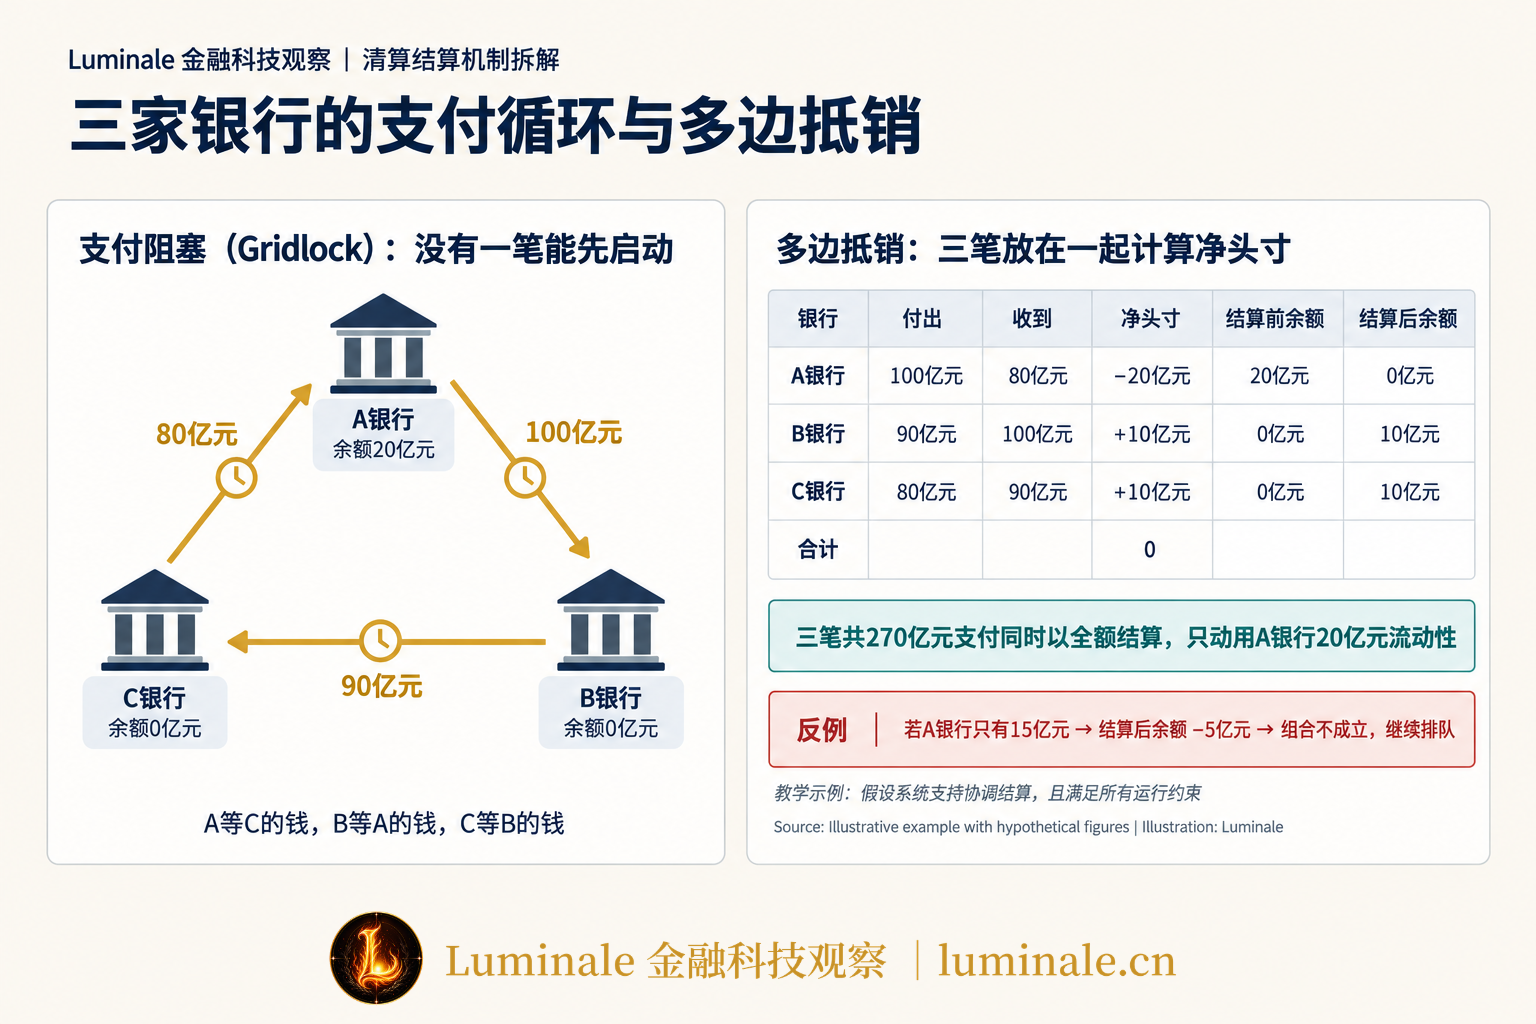
逐笔看,没有一笔能单独结算。A银行要付100亿元,手里只有20亿元,它在等C的80亿元;B银行账上为0,要等A的100亿元才能付给C;C银行同样为0,要等B的90亿元才能付给A。三家银行首尾相接,形成支付循环。
这种状态叫支付阻塞(Gridlock)。从总量看,这组支付并不缺钱:三笔同时结算,A银行需要的净流动性是20亿元,它手里正好有20亿元。阻塞来自执行顺序,三笔支付里找不出一笔能够先启动。
多边抵销(Multilateral Offsetting)把三笔支付放在一起,计算每家银行的净头寸:
| 银行 | 付出 | 收到 | 净头寸 | 结算前余额 | 结算后余额 |
|---|---|---|---|---|---|
| A银行 | 100亿元 | 80亿元 | −20亿元 | 20亿元 | 0亿元 |
| B银行 | 90亿元 | 100亿元 | +10亿元 | 0亿元 | 10亿元 |
| C银行 | 80亿元 | 90亿元 | +10亿元 | 0亿元 | 10亿元 |
三家银行的净头寸相加为零,结算后各自余额都不为负,这组支付就可以同时以全额完成结算。原本卡住的270亿元支付,只动用了A银行的20亿元流动性。打破支付阻塞,有时不需要往系统里加钱,换一种执行方式就够了。
但多边抵销要求条件很严格,稍有变化,结果可能就会不同。假设A银行手里只有15亿元,三笔支付放在一起,A的结算后余额会变成−5亿元,组合不能成立。系统只能继续等,等A收到其他款项,或者等队列里出现新的支付,凑成新的可结算组合。
真实系统里的约束远多于余额是否为负:
- 可用余额。 参与者未必允许排队支付动用全部余额。CHAPS中,非紧急支付只能使用参与者划给非紧急通道的那部分余额[1]。
- 限额。 参与者可以对全体对手方或单个对手方设定净付出上限。CHAPS的多边限额如果设为1,000万英镑,参与者付出的金额就不能比从其他所有参与者收到的多出1,000万英镑以上;双边限额则针对某一家对手方[1]。
- 指令状态与规则。 被暂停的指令、超过金额上限而待人工放行的指令,都不能进入组合。
组合中只要有一家银行触碰约束,算法就得把部分支付剔出去再算一遍。剔掉一笔,别家的净头寸也会跟着变,可能引出连锁调整。CHAPS的处理方式是把违反参与者设定参数的支付识别出来,移出本轮抵销周期,留在队列里等下一轮,其余支付同时结算[1]。参与者越多、排队支付越多,找出能结算尽可能多支付的组合就越难,各系统的优化算法也各不相同,关于具体的算法,本文不做深入探讨,留待以后专门研究。
五、真实的RTGS系统怎样使用这些机制
前面的例子都做了简化。下面看三个不同司法管辖区中央银行大额支付系统,它们是如何通过排队调度来实现流动性节约的。
5.1 英国CHAPS:在RTGS里嵌入流动性节约机制
CHAPS是英国的大额英镑支付系统。2013年4月,英格兰银行在这套基础设施里引入了流动性节约机制(Liquidity Saving Mechanism, LSM)[2]。
引入的背景与监管变化有关。2007—2008年金融危机之前,银行持有的流动性缓冲用来应对资产负债表压力,日间支付也顺带从这笔缓冲里周转;危机后的监管改革要求银行为日常支付另备一块流动性,持有流动性的成本随之上升。银行有了压缩支付所需流动性的动机,这成为英格兰银行开发LSM的主要原因之一[1]。
引入LSM后,CHAPS支付分成紧急和非紧急两条通道结算。一天中的大部分时间,RTGS只处理紧急支付;每隔2分钟,系统短暂暂停紧急支付的实时结算,平均约20秒,运行一轮抵销周期(Offsetting Cycle)。匹配算法在排队支付中寻找彼此抵销、且不违反任何参与者参数的支付组合,在周期结束时让它们同时结算。此前因余额不足没能结算的紧急支付,也会被纳入抵销周期并排在队列前面;周期运行期间新提交的支付,进入下一轮。CHAPS营业日结束前30分钟,仍在排队的支付自动升为紧急[1]。
为配合两条通道,参与者的结算账户余额在操作上被分成两部分:一部分只留给紧急支付,称为紧急备付余额(Headroom);另一部分是所有支付都能使用的非紧急余额。非紧急余额设得越低,非紧急支付就越依赖抵销才能结算,节约的流动性越多,等待也可能越久[1]。
LSM的效果有两组数据可以参考,都对应特定时期。英格兰银行2014年第二季度《季度公报》的研究显示,LSM使CHAPS银行的日间流动性需求下降约20%,约合40亿英镑[2]。2021年版用户指南则提到,2019年LSM帮助全体CHAPS直接参与者节约了大约20%至30%的日间流动性[1]。
LSM还改变了银行的付款动机。日间流动性有成本,银行又控制不了别人何时付款给自己,因此有理由推迟付款,等收到款项再付出去。这种收款驱动型付款行为(Receipt-reactive Behaviour)如果被所有参与者采用,就可能造成整个系统的支付阻塞,先付款的银行反而吃亏。有了LSM,早提交的支付更容易找到抵销对象,银行先付款的顾虑小了很多[1]。英格兰银行2014年的研究也认为,LSM减少了银行为节约日间流动性而采取不利行为的动机,提高了CHAPS的韧性和效率[2]。CHAPS规则同时要求参与者及时提交支付,原则上只在应急情形下才允许银行使用自己的内部排队程序[1]。
5.2 欧元区T2:结算与流动性管理两个组件
T2是欧元体系的RTGS系统。根据欧洲中央银行的介绍,支付指令在T2中以中央银行货币逐笔、连续地结算,结算即具有最终性,单笔金额没有上下限。T2由两个主要组件构成:中央流动性管理(Central Liquidity Management, CLM)组件帮助参与者在各项TARGET服务之间管理日间流动性;RTGS组件提供支付优先级、定时交易、流动性预留、限额、流动性池和优化程序等流动性节约功能[3]。
5.3 香港CHATS:多币种RTGS的流动性优化工具
香港的港元RTGS系统又称港元结算所自动转账系统(Clearing House Automated Transfer System, CHATS),1996年启用,银行间支付在香港金融管理局的账簿上逐笔、连续结算,不做轧差。金管局列出的流动性节约工具包括CHATS优化器(CHATS Optimiser)、RTGS流动性优化器(RTGS Liquidity Optimiser)、跨币种CHATS优化器和与中央结算系统(CCASS)相关的优化器,目的是让支付更顺畅地流转、提高银行流动性的使用效率[4]。
下表由 Luminale 根据英格兰银行、欧洲中央银行和香港金融管理局公开资料整理:
| 系统 | 结算方式 | 排队与调度 | 流动性节约安排 |
|---|---|---|---|
| CHAPS(英国) | 英格兰银行RTGS,逐笔全额 | 紧急与非紧急两条通道,优先级代码,排队顺序轮换 | 每2分钟一轮抵销周期,同时全额结算;双边和多边限额 |
| T2(欧元区) | 中央银行货币,逐笔连续结算,即时最终性 | 支付优先级、定时交易 | 流动性预留、限额、流动性池、优化程序 |
| CHATS(香港) | 金管局账簿,逐笔连续结算,不轧差 | 依系统规则 | CHATS优化器、RTGS流动性优化器等 |
表中资料来源:Bank of England LSM User Guide(2021年2月版)与2014年第二季度《季度公报》、ECB关于T2的介绍页、HKMA支付系统介绍页[1][2][3][4]。
把这些机制放回支付系统的整体框架里看,排队调度和流动性节约属于结算环节内部的运行安排,它们改变的是同一批支付在RTGS里的结算顺序和组合方式,结算资产仍然是中央银行货币,结算方式仍然是逐笔全额。
六、结语:用有限的流动性完成更多结算
回到标题里的问题。RTGS中的支付会排队,是因为付款行的资金或其他规则条件暂时没有满足;排队的指令按先进先出、优先级和队列重排等规则调度,规则不同,同一笔余额能结掉的支付也不同;流动性节约机制在排队支付中寻找双边或多边可以抵销的组合,按系统规则让它们同时以全额结算,用更少的流动性完成更多支付。
这套机制有它的边界。
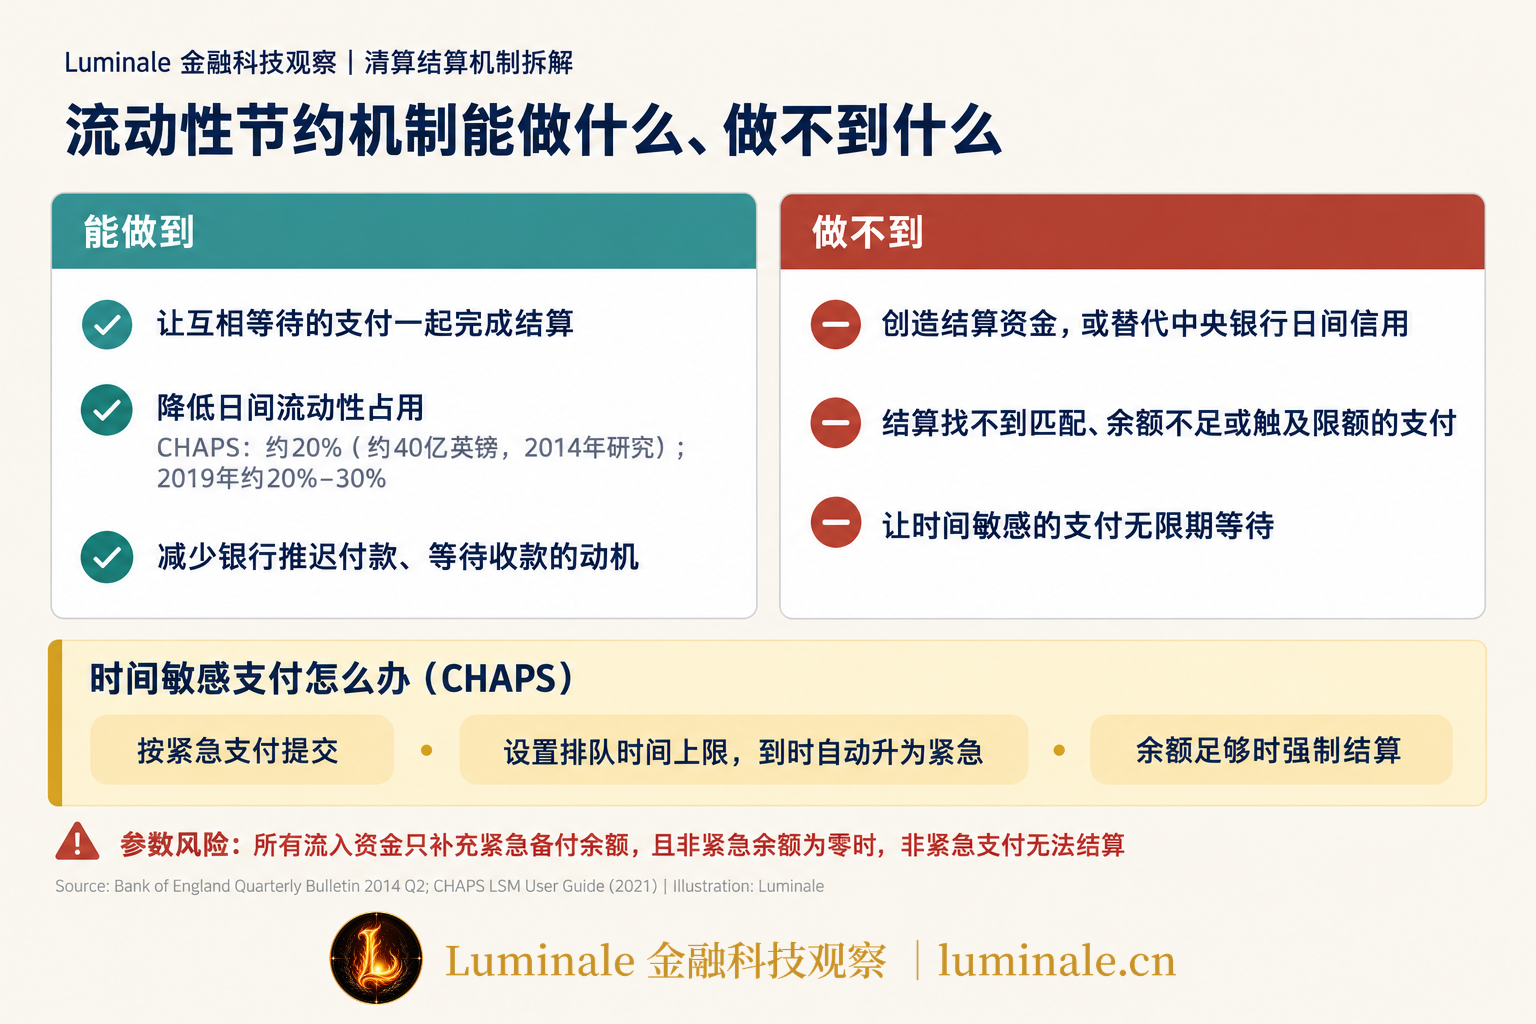
LSM提高的是现有流动性的使用效率,它不创造结算资金,也替代不了中央银行日间信用等流动性供给。找不到匹配的支付、可用余额不足或触及限额时,支付照样无法结算。参数设置不当还可能适得其反:按CHAPS用户指南的说明,参与者如果打开了让所有流入资金只补充紧急备付余额的设置,同时非紧急余额为零,非紧急支付将一笔也结不了[1]。
撮合也有等待成本。排队越久,越有机会找到抵销对象,可有些支付对时间很敏感,比如证券结算、外汇交易的资金交割或者临近截止时间的客户付款,不能为了节约流动性无限期等下去。CHAPS为此提供了几种办法:直接按紧急支付提交、设置排队时间上限后自动升为紧急,或者在余额足够时强制结算[1]。
一个成熟的RTGS系统,在资金充足时能让每笔支付立即完成,在资金暂时不足时能合理安排支付顺序,让既有流动性尽量发挥作用。排队让支付可以等,流动性节约机制则让互相等待的支付找到彼此、一起完成。衡量支付系统的效率,单笔交易的处理速度只是一部分,整个系统能否用有限的流动性持续完成结算同样重要,这需要在结算及时性、最终性、流动性使用效率和系统稳定性之间找到平衡。
参考资料
[1]: Bank of England, CHAPS Liquidity Saving Mechanism User Guide, February 2021. https://www.bankofengland.co.uk/-/media/boe/files/payments/liquidity-saving-mechanism-user-guide.pdf ↩
[2]: Nick Davey and Daniel Gray, How has the Liquidity Saving Mechanism reduced banks' intraday liquidity costs in CHAPS?, Bank of England Quarterly Bulletin 2014 Q2, 2014-06-16. https://www.bankofengland.co.uk/quarterly-bulletin/2014/q2/how-has-the-liquidity-saving-mechanism-reduced-banks-intraday-liquidity-costs-in-chaps ↩
[3]: European Central Bank, What is T2?. https://www.ecb.europa.eu/paym/target/t2/html/index.en.html ↩
[4]: Hong Kong Monetary Authority, Payment Systems. https://www.hkma.gov.hk/eng/key-functions/international-financial-centre/financial-market-infrastructure/payment-systems/ ↩
本文首发于 Luminale 金融科技观察:https://luminale.cn/articles/rtgs-queue-liquidity-saving-mechanisms